Rice分布的数值计算

[latexpage]

我在极坐标下的二维无规行走中讨论到Rice分布:

\begin{equation}\label{eq:1}
p_R\left(r\right)=\frac{r}{\sigma^2}I_0\left(\frac{r\mu_r}{\sigma^2}\right)\exp\left(-\frac{r^2+\mu_r^2}{2\sigma^2}\right)
\end{equation}

当无规行走发生的“位置”($\mu_r$)离原点很远时,$\mu_r$值很大,而分布的极值也大至处于$r=\mu_r$处,因此,能看到分布主要特征的$r$范围也在$\mu_r$附近。这时,式(\ref{eq:1})中的第一类修正贝塞尔函数$I_0\left(\frac{r\mu_r}{\sigma^2}\right)$的值会很大,而自然指数项$\exp\left(-\frac{r^2+\mu_r^2}{2\sigma^2}\right)$会很小,但整个式(\ref{eq:1})的值仍然是适中的。在MATLAB输入上式计算时,会因为计算过程中涉及到很大的和很小的值,所以尽管最终结果的值是适中的,计算也会溢出。这时可以利用第一类修正贝塞尔函数的渐近展开。当$\alpha$为定值、$\left|z\right|$很大且$\left|\mathrm{arg}z\right|<\frac{\pi}{2}$时, \begin{equation}\label{eq:2} \begin{aligned} I_\alpha\left(z\right)&=\frac{\exp\left(z\right)}{\sqrt{2\pi z}}\left[1-\frac{4\alpha^2-1}{8z}-\frac{\left(4\alpha^2-1\right)\left(4\alpha^2-9\right)}{2!\left(8z\right)^2}\right.\\ &\left.-\frac{\left(4\alpha^2-1\right)\left(4\alpha^2-9\right)\left(4\alpha^2-25\right)}{3!\left(8z\right)^3}+\cdots\right]\\ &\approx\frac{\exp\left(z\right)}{\sqrt{2\pi z}}\left[1+O\left(z^{-1}\right)\right] \end{aligned} \end{equation} $z$越大,级数会衰减得越快.如果$z$足够大,$I_0$可近似为$\frac{\exp\left(z\right)}{\sqrt{2\pi z}}$。这个近似式并不改变$I_0$很大的事实。但如果将式(\ref{eq:2})代入式(\ref{eq:1}), \begin{equation}\label{eq:3} p_R\left(r\right)=\frac{r\exp\left[-\frac{\left(r-\mu_r\right)^2}{2\sigma^2}\right]}{\sqrt{2\pi r\mu_r\sigma^2}}\left[1+\frac{\sigma^2}{8r\mu_r}-\frac{9\sigma^4}{128r^2\mu_r^2}+\cdots\right] \end{equation} 可见,无论$\mu_r$多大,$p_r\left(r\right)$其实只跟$r$与$\mu_r$之差有关。式(\ref{eq:3})只需要计算$\exp\left[-\left(r-\mu_r\right)^2\right]$。由于Rice分布的$r$范围主要在$\mu_r$附近,因此$r$与$\mu_r$之差是很小的,因此这一计算不会溢出。 实际计算时,可先判断$\mu_r$和$\sigma^2$的取值是否使式(\ref{eq:1})的计算溢出了,若溢出,按式(\ref{eq:3})计算时,可根据$\mu_r$和$\sigma^2$的取值大小决定舍去级数的哪些尾项。按照MATLAB的计算极限,能让式(\ref{eq:1})溢出的情况,也就必然能使式(\ref{eq:3})的所有尾项都舍去了。

影响因子2016

2016年最新影响因子统计结果出来了。其实我感觉影响因子在我们圈内的话题色彩就跟微信朋友圈里疯转的“你一定要知道这10件事”类型的信息差不多。大家明知低俗,偏偏又疯狂关注。每隔两年的高潮,你没办法错过。

今年属于我参加工作第4年,算是在这方面部分认识了自己,即假如我做科研,我是哪种类型的研究者。原来我是特别矫情的那种,特别理想化,学人家“反对唯影响因子论”;但自己实力又很弱,十分需要影响因子(钱)打救的那种人。

在这次影响因子出炉前后恰好看到两个相关的文章,我也作些评论。

首先是《诺奖得主:以期刊影响因子论英雄是“懒人做法” |专访》,以下我将受访人针对不同问题的观点分开了。

1

当然,那些所谓的顶级期刊的问题并不是它们不发表重要文章,而是作为其商业计划的一部分,它们发表的文章往往非常具有选择性。……

我认为那些顶级期刊只是商业计划的一部分,他们的确是非常成功的商人,建立了非常具有影响力的品牌,以至于在很多地方,在这些期刊上发表文章被看作是衡量成就的标准,人们会以此为基础得到晋升或提高薪资,从而导致对知识评估的扭曲。研究人员需要极力自我推销,才能将他们的论文发表在这些期刊上。

关于期刊影响因子的商业因素,我在之前的文章也已经提及过,这里就不重复了。我想在此补充一个疑问:观察现时最成功的几个出版商最近几年推出的新期刊,我感觉这些出版商在保持“编辑的独立性”的同时,似乎对期刊的影响因子有很大的调控力。我怀疑,除了汤森·路透社在科学计量学方面进行研究之外,这些出版商内部一定有以汤森·路透社的研究方法为对象的研究,例如研究对于给定的一种期刊影响力统计方法,在保持编审独立性的前提下,各种出版行为和工具对统计结果有何影响。这类研究甚至可能是长期的,早有成熟的结论。因此不仅是现在对于每两年的影响因子这种实行了行多年的统计方式这些出版社已经驾轻就熟;就算将来因为对影响因子的批评呼声太高而更换了一种普遍认为更加科学的统计方式,这些出版商也能够很快赶上技术进步。出版商会一直垄断这个地位,除非汤森·路透社反过来将出版商的商业行为作为一种因素纳入其研究中,将出版商视为“假想敌”,大家互相研究对方,陷入“道高一尺魔高一丈”的循环……其实,问题的根本还是我上一篇文章所说的:科研的极度职业化。你职业化,就极需要一种评价。很多对影响因子滥用的批评都喜欢说“影响因子最初只是为了方便图书馆选购期刊”。但当我们急需一种评价体系,又十分要求这个体系公平、科学的话,向科学计量学寻求这个工具当然是最公平、最科学的做法。

我在武夷山老师的博客里这么评论:

您好像也说过,科学计量学不负责去规定人家如何使用这些指标。

但是也许作为外行人最原始的误解焦点不在于“使用不当”,而是觉得这种仅凭关键词和数据即可作出准确预测的技术在当今“publish or perish”的时代具有强大的吸引力,却游离于真正得到同行确认的科学问题需求之外。似乎是说,假如你只想发表高影响论文,现在并不需要直接去思考“研究什么”,只需去参考数据分析报告即可。

我相信,把科研活动作为一个大量群体的人类活动来研究,是出于未知的好奇。而研究自然是经验和理性结合的,必然会想找规律、找模式。而验证规律或模式的方法,免不了去预测。只有验证成功了,好奇心才得到满足。然而一但验证成功,一个预测指标也同时形成,你又规定不了别人拿不拿去用、怎么用。

更何况更多科学计量学者自诩的意义是更加积极入世的,就是“为科技政策的制定”提供参考。我只能怪今天这个时代不是法拉第的时代。今天推动科研是一种国家行为,科研人员是一种受雇佣关系。国家需要制定指南、政策。科研人员publish or perish。

会不会有这种情况,大家都不关心科学上的兴趣,只关心晋升所需要的论文影响和档次。此时,优异的大数据预测能力成了大家必备的参考。一个偶然的小坑可能会形成黑洞,吸引大量人员来哄抬。整个科研圈就好像微博一样或者像娱乐圈一样,是一个随机系统,或者甚至是混沌。科研圈开始出现炒作团队,专门研究热门背后的逻辑,为热门而热门,名星和经理人机制形成……

他这样回复:

不当后果是难免的,整个科学事业都是这样。

我只想说,摆脱科学计量学(不管是好是坏)是不可能了。有人觉得,同行评议好得很,但这些同行在参加评审之前,很可能已经看过一些科学计量学指标,从而受到了影响。如果排除掉这些同行,就好比凡是看过报纸电视的都不让进陪审团,结果,只有无知者才能进陪审团。

这也是很有高度的回应,说明简单地去反对影响因子至少是不够深思熟虑的。

2

当我有机会开始创建新期刊eLife之后,我们决定赋予其全新的面貌:我们不需要影响因子。……

审稿人会在网上聊天室进行沟通,决定一篇文章结论是否合理,或是还需要进一步修改。……

例如,我的实验室有一对来自上海的年轻夫妻搭档,他们都是非常优秀的科学家,现在已经发表了3篇eLife文章。我确定他们的成果绝对可以在CNS上发表,但是我不允许。我这名同事告诉我,如果这样他将很难在中国找到好工作,因为他在争取资助方面没有竞争优势,中国的评价系统青睐CNS文章作者。我认为他有实力当选“青年千人”,而且一个人的知识不应该以此来评判;但他在上海的导师却说如果他没有在上述期刊上发表文章,就会很难入选。

我们希望给青年人才提供新的平台,也为此做了很多工作,比如我们会给文章的第一作者写求职或奖学金申请推荐信。我认为与《自然》等杂志的主编相比,他们会更愿意请我写这封推荐信。所以,我们在非常努力地得到科研人员的认可。可以说,我们在逐步走向成功,尽管速度有些慢。

很明显,这位受访者打算通过建立一个期刊的方法来对抗影响因子。除了自己建立一个期刊,另一个有力的工具就是他本人作为诺贝尔奖得主的影响力。他让自己的学生在一个没有影响因子的期刊上发表文章,然后靠写推荐信来保证其学生在这个讲究影响因子的世界中获得应有的肯定和报酬——这是反抗影响因子吗?这反而是承认甚至加强了影响因子的地位。

3

研究人员为了评职称或升级进行考评时,应该设置一个委员会对个人进行评估,委员会可以聚焦阅读数量有限的申请者的高质量论文。……

如果学术职位或是奖学金申请人很多,委员会不可能阅读他们的全部论文。那么,每个人在其职业初期都应该有一段描述个人成绩的话,我们将其称作“影响力陈述”。这段应该写得非常仔细、慎重、有特点,能概括个人最重要的发现。这样无论你在任何时候申请什么,它都能发挥作用。委员会也可以在读完这些简要的段落后,挑选出最适宜某个职位的候选人名单,然后再详细阅读短名单中的论文内容。

如果说到我们对科研成果的评价方式,那就涉及一个更加庞大的问题了。首先,很显然任何一个圈内人都人认为上述这种做法是不可行的——因为大家都没有这么多时间如此认真对待手头上的每一个candidates。在这个至今仍然坚持同行评议传统的圈子,任何一个地位不需要太高的圈内人都会面对各种评审任务,包括论文、基金项目和人才引进。这些同行评议工作量之大使得即使是一个对影响因子滥用深恶痛绝的人也不得不借助它来快速完成筛选淘汰任务。但同时,没有一个圈内人会认为上述这种做法有什么错。于是便要问,为什么会有这么大量的评审任务?我认为,这是因为当前做研究的人太多了!根本不需要这么多人来做研究。但这个问题甚至比影响因子滥用问题更微妙,更不便于提出,因为它“政治不正确”。只能眼看各国科研投入比例越来越大,做研究的人员越来越多,每年提出的基金项目也越来越多。真正需要解决的科学问题就是那几个,但就是因为这么多人的饭碗要顾及,同时也确实有这么多资金等待发放,大量自说自话的研究也得于资助。于是这么多人都走上了这条职业道路,就要发表这么多论文来博得升迁机会。所以各大出版商连年设立新期刊,期刊数量越来越多反而每个期刊都不缺少优秀稿源,所有新期刊的影响因子创新高,表示还有设立更多新期刊的空间。只要将现时从事科学研究的人员和机构砍剩十分之一(也即是我这种庸才也被砍去),整个世界便清静了。可是,你怎么砍?你是否又要借助某种“公平的”评价工具?或者就是“最后用一次”它,以换来长久的清静?

另一篇相关的文章是《诱惑与困惑:“影响因子游戏”该如何继续?》。这篇文章用很大的篇幅介绍了关于影响因子的背影信息,最后介绍了“旧金山宣言”。反对滥用影响因子的现象,只算是一种“破”。有破也要有立。“旧金山宣言”就是一种立。经过前文的讨论,我对这一堆“宣言”的评价是:太理想,也太温和。

极坐标下的二维无规行走

[latexpage]

这几天我在李俊杰、Mathematica的帮助下推导了极坐标下的二维布朗运动的统计。一开始我就觉得,这是很基本的问题,应该会有相应的例题或课件直接给出答案。但是一开始搜都搜不到。我用体育老师教的数学推了半天,出结果之后,就立马搜到资料了。只当作上天逼我练习一下大学的数学吧。

我要考虑的问题是二维无规行走的极坐标的统计,即极径和极角的分布。之前我总结过了二维和三维无规行走的极径分布分别是Rayleigh分布和Maxwell分布,这都是直角坐标的期望值为零的情况。本文一是要考虑期望值不为零的情况,二是不光考虑极径的分布,还要考虑极角的。

二维无规行走的“轨迹中心”

一个走了N步的二维无规行走轨迹应该是有其中心的。例如,可以定义这个中心为无规行走的x坐标和y坐标的期望值$\mu_X$和$\mu_Y$。这样的定义严格来说并不实用,因为对于给定的有限步数的轨迹,我们无法知道期望值,只能计算均值。后者只有$N\rightarrow\infty$时才是期望值。为了实验方便,我定义二维无规行走的轨迹“中心”是其起始坐标$\left(x_0,y_0\right)$。这样,不仅对任意一个给定的轨迹都能直接说出其“中心”,还能主动实现一个给定中心的“无规行走”——只要从你的行走是从那个中心开始的就行。凭直观想象,一个从点$\left(x_0,y_0\right)$出发的无规行走,只要步数$N$足够大,就有$\mu_X=x_0$和$\mu_Y=y_0$。当然,这是为了实验的思考。接下来的推导都是谈期望值

期望值为零的情况

首先,考虑一个“在原点处”的无规行走,即其x坐标和y坐标的期望值$\mu_X=\mu_Y=0$,方差都是$\sigma^2$(各向同性)。这时其极坐标的极径和极角$r$和$\theta$的分布分别为一个Rayleigh分布和一个均匀分布:

\begin{equation}\label{eq:1}
p_R\left(r\right)=\frac{r}{\sigma^2}\exp\left[-\frac{r^2}{2\sigma^2}\right]
\end{equation}
\begin{equation}\label{eq:2}
p_\Theta\left(\theta\right)=\frac{1}{2\pi}
\end{equation}

期望值不为零的情况

考虑“位于极坐标中点$\left(\mu_r,\mu_\theta\right)$处的无规行走,即其直角坐标x和y的期望值为$\mu_X和\mu_Y$,方差都是$\sigma^2$(各向同性)。于是

\begin{equation}\label{eq:3}
\begin{aligned}
\mu_r&=\sqrt{\mu_X^2+\mu_Y^2}
\\
\mu_\theta&=\left\{\begin{matrix}
\arctan\frac{\mu_Y}{\mu_X}, & x>0\\
\arctan\frac{\mu_Y}{\mu_X}+\pi, &x<0
\end{matrix}\right.
\end{aligned}\end{equation}

则极径$r$和极角$\theta$的联合分布为

\begin{equation}\label{eq:4}
p_{R\Theta}\left(r,\theta\right)=\frac{r}{2\pi\sigma^2}\exp\left[-\frac{r^2+\mu_r^2-2r\mu_r\cos\left(\theta-\mu_\theta\right)}{2\sigma^2}\right]
\end{equation}

由于无规行走的极径和极角是相互独立的随机量,所以求两个边缘分布就可以了。

\begin{equation}
\begin{aligned}
p_R\left(r\right)&=\int_0^{2\pi}p_{R\Theta}d\theta\\
p_\Theta\left(\theta\right)&=\int_0^\infty p_{R\Theta}dr
\end{aligned}
\end{equation}

这两个积分都无法用初等函数表示。我是用Mathematica来算的,结果如下:

\begin{equation}\label{eq:6}
p_R\left(r\right)=\frac{r}{\sigma^2}I_0\left(\frac{r\mu_r}{\sigma^2}\right)\exp\left(-\frac{r^2+\mu_r^2}{2\sigma^2}\right)
\end{equation}

\begin{equation}\label{eq:7}
\begin{aligned}
p_\Theta\left(\theta\right)=&\frac{1}{\sqrt{8\pi\sigma^2}}\mu_r\cos\left(\theta-\mu_\theta\right)\exp\left[-\frac{\mu_r^2\sin^2\left(\theta-\mu_\theta\right)}{2\sigma^2}\right]\times \\
&\left[\mathrm{erf}}\left(\frac{\mu_r\cos\left(\theta-\mu_\theta\right)}{\sqrt{2\sigma^2}}\right)+1\right]+\frac{1}{2\pi}\exp\left(-\frac{\mu_r^2}{2\sigma^2}\right)
\end{aligned}
\end{equation}

其中,$I_0\left(x\right)$是零阶第一类Bessel函数

\begin{equation}
I_0\left(x\right)=\frac{1}{\pi}\int_0^\pi\exp\left(x\cos\theta\right)d\theta
\end{equation}

$\mathrm{erf}\left(x\right)$是误差函数

\begin{equation}
\mathrm{erf}\left(x\right)=\frac{2}{\sqrt{\pi}}\int_0^x e^{-t^2}dt
\end{equation}

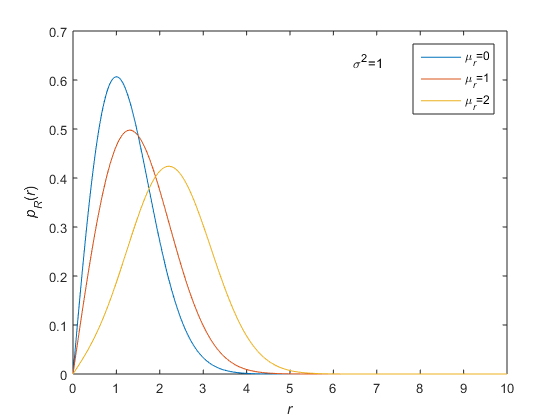
式(\ref{eq:6})其实就是Rice分布,当$\mu_r=0$时退化为Rayleigh分布(式(\ref{eq:1}))。下图是固定$\sigma^2=1$,$\mu_r=0,1,2$的分布曲线:
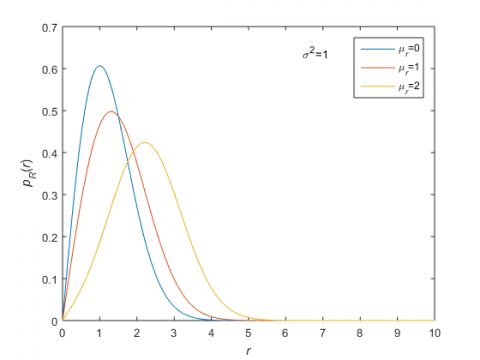
Rice distributions of varying expetation

Rice distributions of varying expectations

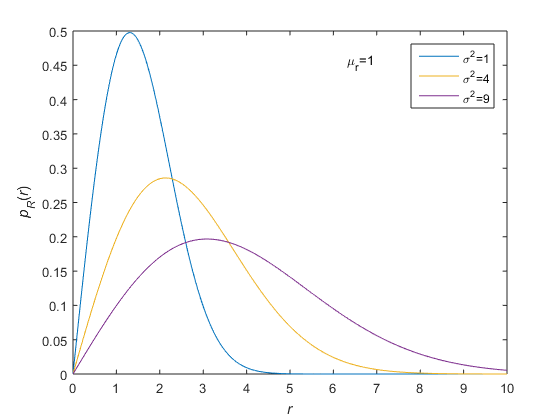
下图是固定$\mu_r=1$,$\sigma^2=1,2,3$的分布曲线:
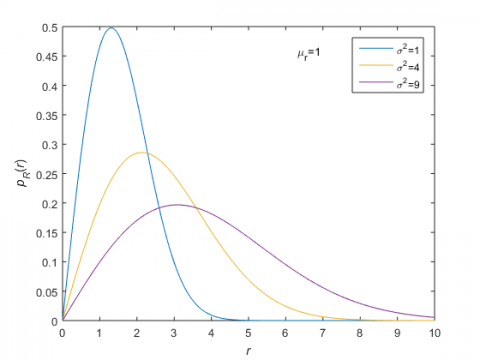
Rice distributions of varying variances

Rice distributions of varying variances

作为极径的分布,Rice分布与极角的期望$\mu_\theta$无关。而极角的分布(式(\ref{eq:7}))与$\mu_r$和$\mu_\theta$都有关。这个分布是否已有人名,我没有找到。我只找到一篇文章讨论更加一般的情况,即两组高斯量X和Y期望值$\mu_x\neq\mu_y\neq0$,且它们的方差也各不相等$\sigma_x\neq\sigma_y$;而且X坐标和Y坐标还是相关的,它们的协方差系数$\rho\neq0$的情况[cite]10.1109/TCOMM.2009.04.070065[/cite]。我是算出式(\ref{eq:7})之后才找到这篇论文的,唯一安慰就是一对照发现我好歹算对了。

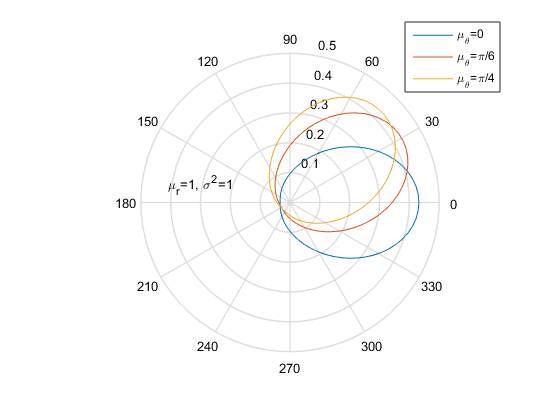
式(\ref{eq:7})在$\mu_r=0$时退化为均一分布$\frac{1}{2\pi}$(式(\ref{eq:2})),这是“在原点处”的无规行走的结果。可以想象,一个远离原点处的二维无规行走,其轨迹相对原点的极角涨落基本会分布在一个很窄的范围之内,而且这个范围主要依赖这个无规行走的“位置”。下图是固定$\mu_r=1$和$\sigma^2=1$,$\mu_\theta=0,\frac{\pi}{6},\frac{\pi}{4}$的结果:
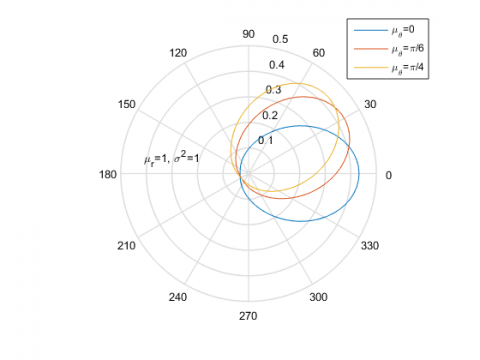
Polar angle distributions of random walk: varying angular expectations

Polar angle distributions of random walk: varying angular expectations

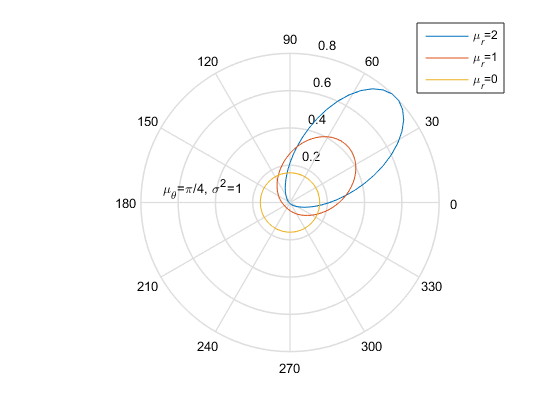
再仔细想,一个给定方差的无规行走,如果离原点近一些,其轨迹的极角涨落会宽一些。下图是固定$\mu_\theta=\frac{\pi}{4}$和$\sigma^2=1$,$\mu_\theta=0,1,2$的结果:
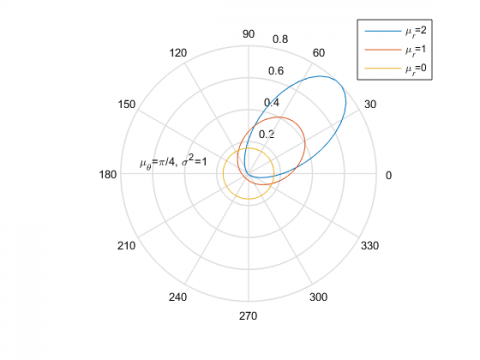
Polar angle distributions of random walk: varying radial expectations

Polar angle distributions of random walk: varying radial expectations

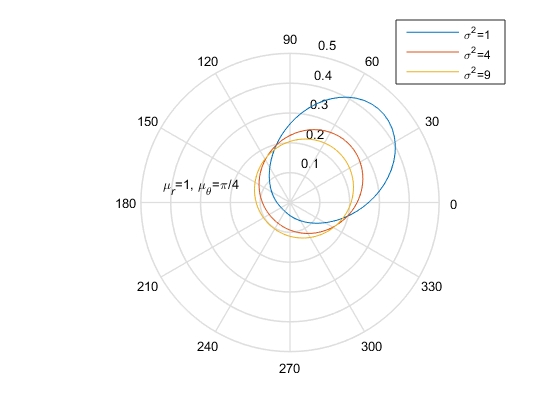
最后,看一下固定$\mu_r=1$和$\mu_\theta=\frac{\pi}{4}$,$\sigma^2=1,4,9$的结果:
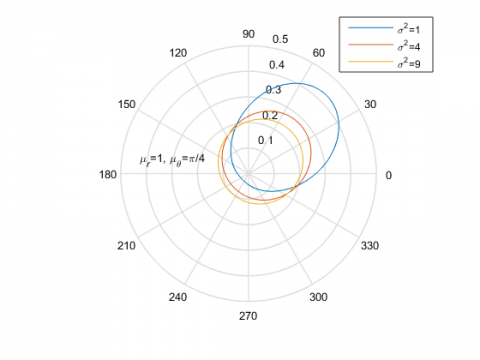
Polar angle distributions of random walk: varying variances
Polar angle distributions of random walk: varying variances